
هل موقعك محجوب عن ChatGPT أو Gemini أو Claude أو Perplexity من غير ما تعرف؟ ممكن تكون عامل كل خطوات تحسين محركات البحث (SEO)، لكن إعداد في robots.txt أو قاعدة في Cloudflare تمنع أدوات الذكاء الاصطناعي من الوصول للمقالات. والمشكلة الأكبر إن بعض أصحاب المواقع بيسمحوا لبوتات التدريب فقط، بينما يمنعوا بوتات البحث اللي ممكن تجيب لهم زيارات وإحالات حقيقية.
في الدليل ده من نولوجي NologyTV، هنعرف أسماء بوتات الذكاء الاصطناعي الرسمية (User-Agents)، وروابط نطاقات الـ IP المنشورة من الشركات نفسها، وإعدادات WordPress وCloudflare، وإزاي تهيئ موقعك للظهور في إجابات الذكاء الاصطناعي أو ما يُعرف بـ GEO – Generative Engine Optimization. آخر مراجعة: 3 نوفمبر 2026.
الخلاصة السريعة: لو هدفك الظهور في نتائج AI، اسمح لبوتات البحث مثل
OAI-SearchBotوPerplexityBotوClaude-SearchBot، وحافظ على إمكانية زحف Googlebot وBingbot. مش لازم تسمح لبوتات التدريب زيGPTBotأوClaudeBot. والسماح بالزحف لا يعني ضمان الأرشفة أو ذكر موقعك في الإجابات.
محتويات الدليل
- الفرق بين بوتات البحث والتدريب والزيارة بطلب المستخدم
- قائمة بوتات AI المهمة حسب الشركة
- روابط قوائم IP الرسمية والمحدثة
- إعدادات robots.txt الجاهزة مع خيارات السماح والمنع
- خطوات WordPress وCloudflare
- ماذا تفعل لتحسين GEO فعليًا؟
- الأسئلة الشائعة والمصادر
أولًا: مش كل بوت ذكاء اصطناعي بيعمل نفس الوظيفة
خلينا نفصل بين 3 أنواع بدل ما نتعامل مع كل الـ AI Bots كأنها شيء واحد:
| النوع | بيعمل إيه؟ | أمثلة | قرار شائع |
|---|---|---|---|
| بوت بحث وفهرسة | يكتشف صفحات الموقع لإظهارها ضمن نتائج البحث أو الإجابات المرتبطة بمصادر | OAI-SearchBot، PerplexityBot، Claude-SearchBot، Googlebot، Bingbot | اسمح بالزحف للصفحات العامة |
| بوت تدريب | يجمع بيانات قد تُستخدم لتدريب أو تطوير نماذج الذكاء الاصطناعي | GPTBot، ClaudeBot، Amazonbot، Meta-ExternalAgent | السماح أو المنع قرار خاص بحقوق المحتوى |
| جلب بطلب المستخدم | يفتح رابطًا عند طلب شخص من المساعد ذلك | ChatGPT-User، Claude-User، Perplexity-User، Amzn-User | يفضل عدم تعطيله إذا كنت تريد إتاحة الروابط للمساعدين |
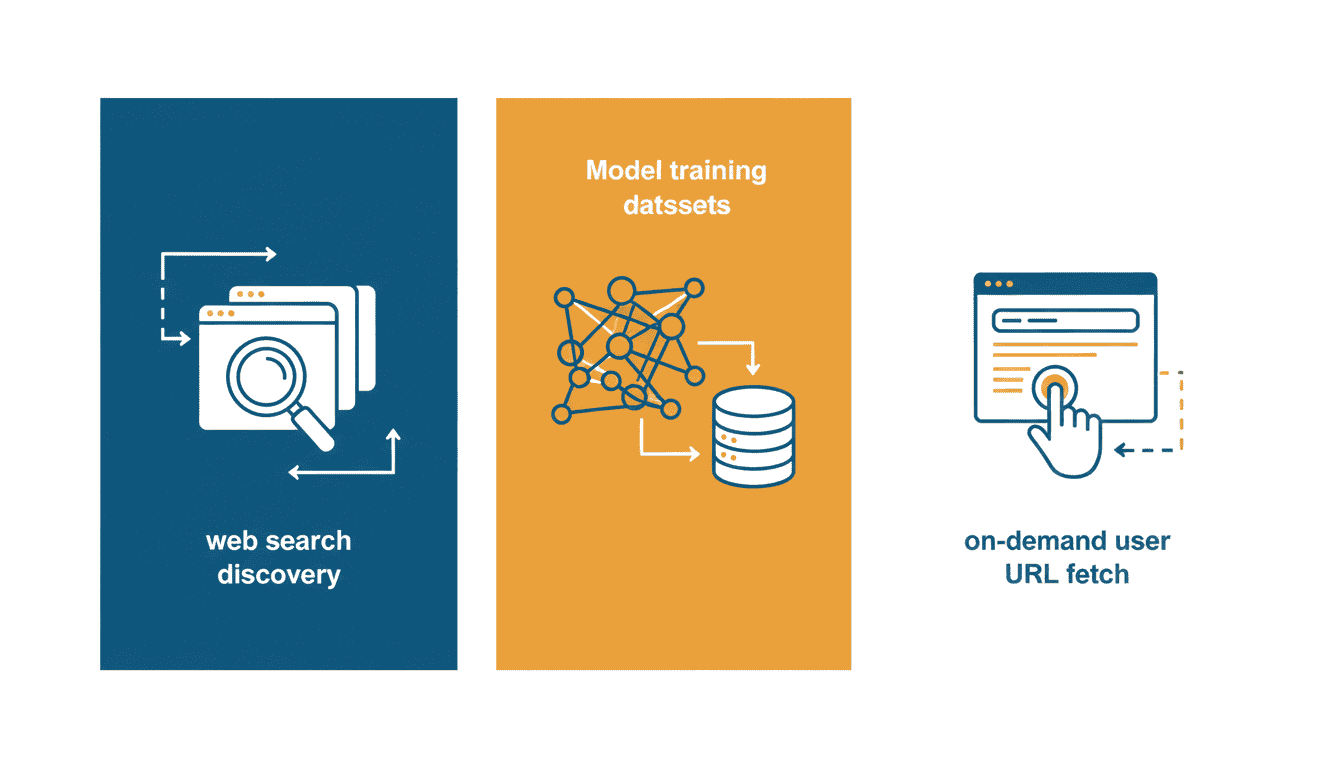
نقطة مهمة: الزحف (Crawling) مش هو نفسه الفهرسة (Indexing)، والفهرسة مش معناها إن مساعد AI هيستشهد بمقالك (Citation). السماح للبوت بيزيل عائقًا تقنيًا فقط، لكن جودة المحتوى ومدى ملاءمته للسؤال بيظلوا عوامل أساسية.
ثانيًا: أهم بوتات AI التي تحتاج معرفتها في 2026
1. OpenAI وChatGPT
| البوت | وظيفته | التعامل المقترح |
|---|---|---|
OAI-SearchBot | اكتشاف الصفحات لنتائج البحث داخل ChatGPT | اسمح إذا كنت تريد ظهور محتواك في ChatGPT Search |
GPTBot | جمع محتوى يمكن استخدامه في تدريب النماذج | يمكن منعه دون منع OAI-SearchBot |
ChatGPT-User | فتح رابط عندما يطلب المستخدم ذلك؛ ليس بوت فهرسة تلقائية | اتركه متاحًا للمحتوى العام، مع العلم أن قواعد robots.txt قد لا تنطبق على كل زيارة بطلب مستخدم |
OAI-AdsBot | فحص صفحات الهبوط لإعلانات ChatGPT | ليس بوت بحث عام، ويهم المعلنين فقط |
تؤكد OpenAI أن التحكم في OAI-SearchBot وGPTBot منفصل؛ ويمكن السماح بالظهور في بحث ChatGPT دون السماح باستخدام المحتوى في التدريب. المرجع: توثيق OpenAI الرسمي.
2. Google وGemini وAI Overviews
Googlebot هو البوت الأساسي لفهرسة بحث Google، بما يشمل المحتوى الذي قد يظهر كروابط داعمة في AI Overviews وAI Mode. أما Google-Extended فهو رمز تحكم في استخدام محتوى Google لمنتجات Gemini، بما فيها التدريب وبعض استخدامات grounding، وليس بوتًا مستقلًا له User-Agent خاص في سجل الزيارات. تعطيل Google-Extended لا يمنع الظهور في بحث Google، لكنه قد يؤثر على فرص استخدام المحتوى ضمن Gemini Apps. راجع توثيق Google.
لذلك لا تخلط بين Google AI Overviews داخل نتائج البحث وبين Gemini Apps. ولو تريد الظهور في ميزات Google التوليدية، تأكد أيضًا من إعدادات Search Console الخاصة بالميزات التوليدية، وتجنب منع عرض المقتطفات (Snippets) للصفحات المهمة.
3. Claude من Anthropic
لدى Anthropic ثلاثة بوتات منفصلة: Claude-SearchBot لدعم جودة نتائج البحث، وClaude-User لجلب محتوى يطلبه المستخدم، وClaudeBot الذي قد يجمع بيانات للتدريب. لو هدفك زيادة فرص الوصول للمقالات عبر Claude، فافصل بين أول اثنين وبوت التدريب. المصدر: دليل Anthropic.
4. Perplexity
PerplexityBot هو بوت البحث الذي يهدف لإظهار الصفحات كرابط ومصدر ضمن إجابات Perplexity، ولا يُستخدم لتدريب النماذج التأسيسية حسب الشركة. وPerplexity-User يفتح الروابط نيابةً عن المستخدم وقد يتجاوز قواعد robots.txt في بعض حالات الجلب. المصدر: Perplexity Crawlers.
5. Microsoft Copilot وBing
وجود صفحاتك في فهرس Bing يظل مهمًا للمنتجات وتجارب البحث التي تعتمد عليه، لذلك لا تمنع bingbot بلا سبب. ويمكن متابعة أخطاء الزحف والفهرسة عبر Bing Webmaster Tools. وإذا كنت تستخدم Copilot Studio مع مصادر الويب، فتوضح Microsoft أن استرجاع النتائج قد يعتمد على فهرس Bing؛ لكن هذا لا يعني أن كل تجربة Copilot تستخدم الآلية نفسها. راجع توثيق Microsoft.
6. Apple وSiri وApple Intelligence
Applebot يدعم اكتشاف المحتوى لتجارب مثل Siri وSpotlight وSafari. ويمكن التحكم في استخدام المحتوى لتدريب نماذج Apple بواسطة Applebot-Extended بشكل منفصل. وتتيح Apple أيضًا التحقق من النطاقات عبر قائمة CIDR رسمية. المصدر: دليل Applebot.
7. Amazon وAlexa
أمازون توضح أن Amzn-SearchBot مخصص لتجارب البحث ومنها Alexa، وAmzn-User لجلب المعلومات بطلب المستخدم، بينما Amazonbot قد يُستخدم أيضًا لتدريب نماذج AI. توضح الشركة نطاقات IP مختلفة لكل فئة. المصدر: توثيق Amazonbot.
8. Meta وBrave وCommon Crawl وبوتات أخرى
meta-externalagentمن Meta يرتبط بالجمع للاستخدامات المتعلقة بتطوير النماذج، بينماmeta-externalfetcherمخصص لزيارات بطلب المستخدم، بحسب تصنيفات Cloudflare. لا تخلط بينها وبين بوتات معاينة الروابط عند المشاركة.CCBotتابع لـ Common Crawl ويُنتج أرشيفات بيانات ويب عامة قد تستخدمها جهات عديدة؛ السماح له ليس شرطًا مباشرًا لظهور موقعك في إجابات AI. التوثيق الرسمي.- Brave Search يمتلك زاحف بحث، لكنه لا يعلن User-Agent مميزًا تستطيع وضعه في robots.txt؛ لا تعتمد على اسم
Bravebotوكأنه معرف رسمي. توضيح Brave. - تسجل Cloudflare أيضًا بوتات مثل
BytespiderوDuckAssistBotوMistralAI-User. ظهورها في القوائم لا يعني وجود قائمة IP موثوقة أو سياسة استخدام واحدة تنطبق على الجميع.
ثالثًا: روابط IP الرسمية لبوتات الذكاء الاصطناعي (محدثة من المصدر)
بدل ما ننسخ مئات عناوين الـ IP في مقالة قد تصبح قديمة بعد أسبوع، الأفضل نحتفظ بروابط JSON / CIDR الرسمية ونستخدمها لإعداد قواعد الحماية بشكل قابل للتحديث. رابط الـ IP وحده لا يمنح البوت حق الوصول تلقائيًا، ولا يثبت أن الطلب حقيقي إذا كان الـ User-Agent مزورًا.
| الشركة / البوت | الرابط الرسمي لعناوين IP |
|---|---|
| OpenAI – OAI-SearchBot | searchbot.json |
| OpenAI – GPTBot | gptbot.json |
| OpenAI – ChatGPT-User | chatgpt-user.json |
| PerplexityBot | perplexitybot.json |
| Perplexity-User | perplexity-user.json |
| Googlebot | Googlebot IP JSON |
| Google – Common Crawlers | common-crawlers.json |
| Applebot | Applebot CIDR JSON |
| Common Crawl – CCBot | ccbot.json |
| Amazonbot / Alexa | نطاقات بوتات Amazon الرسمية |
| Anthropic / Claude | توثيق التحقق وإدارة البوتات |
| Meta / Bot directory | دليل البوتات الموثقة في Cloudflare |
تنبيه أمني: المصدر الذي يعرض قوائم IP من طرف ثالث مفيد للاطلاع، لكنه لا يجب أن يكون المرجع الوحيد لفتح جدار الحماية. استخدم الروابط الرسمية أعلاه، وحدث قوائم CIDR بصورة دورية، واربط عنوان الـ IP بنوع البوت المطلوب. ولا تفتح جميع عناوين مراكز بيانات OpenAI أو Google أو AWS باعتبارها «بوتات موثوقة».
رابعًا: مثال robots.txt عملي للسماح ببوتات البحث ومنع التدريب
لو هدفك الأساسي زيادة فرص ظهور موقعك في إجابات البحث، مع عدم السماح لبعض البوتات بتجميع المحتوى للتدريب، فهذا مثال توضيحي يمكن دمجه بعناية مع قواعدك الحالية. لا تستبدل ملف robots.txt كاملًا بالمثال؛ لازم تحتفظ بإعدادات القالب والإضافات وملف Sitemap وأي قيود أساسية عندك.
# Search-oriented crawlers
User-agent: OAI-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: Googlebot
Allow: /

User-agent: bingbot
Allow: /

User-agent: Applebot
Allow: /

User-agent: Amzn-SearchBot
Allow: /

# Optional: decline selected training crawlers
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: meta-externalagent
Disallow: /

# Add this only after reviewing your Gemini goals:
# User-agent: Google-Extended
# Disallow: /
هذا المثال لا يغطي وحده كل التعليمات اللازمة لموقع WordPress؛ عند إنشاء مجموعة User-agent مستقلة قد تتغير طريقة تطبيق القواعد العامة الخاصة بـ * على البوت المعني. راجع بالتحديد مسارات الإدارة، وملفات Sitemap، وأي استثناءات موجودة، واختبر كل نوع بوت بعد التعديل. كذلك robots.txt ليس وسيلة لحماية الملفات الحساسة؛ استخدم المصادقة أو قواعد الحماية الفعلية.
قرار التدريب قرارك: إذا كنت تريد تغطية أوسع لدى جميع المنتجات، لا تمنع التدريب تلقائيًا قبل معرفة أثره. مثلًا Google-Extended يتحكم أيضًا في بعض حالات grounding داخل Gemini Apps، وليس تدريب النموذج فقط. أمّا ChatGPT-User وPerplexity-User فزياراتهما بطلب المستخدم قد لا تتبع robots.txt دائمًا؛ لذلك لا تعتمد على الملف كجدار حماية ضدها.
هل نضيف علامة جديدة مشتركة لمنع تدريب AI؟
في 30 أكتوبر 2026 أعلنت Google دعمها المستقبلي لإشارة مشتركة ضمن مشروع AIPREF للتحكم في استخدام المحتوى في تدريب النماذج. من المخطط بدء دعمها خلال 2027، فلا تعتبرها بديلًا مطبقًا حاليًا لقواعد الشركات المعروفة. التفاصيل: إعلان Google الرسمي.
خامسًا: كيف تضبط WordPress وCloudflare من غير ما تحظر الزحف؟
- افتح
yourdomain.com/robots.txtوتأكد أنه لا يوجدDisallow: /في مجموعة تنطبق على بوت البحث المستهدف. - في WordPress ادخل Settings → Reading وتأكد أن خيار منع محركات البحث من أرشفة الموقع غير مفعل (للمواقع العامة).
- افحص إعدادات Yoast SEO أو إضافة SEO المستخدمة للتأكد من أن صفحات المقالات المهمة ليست
noindex، وأنها موجودة في الـ XML Sitemap. - إذا كنت تستخدم Cloudflare، افتح AI Crawl Control → Crawlers وراجع حالة كل بوت. لا تكتفِ بكلمة Allow؛ تحقق من قواعد WAF وBot Fight Mode وManaged Challenges التي قد تستمر في حظر الطلبات.
- في Security → Security Rules راجع القواعد التي تعطي 403 أو تحديات لبوتات البحث. عند عمل استثناء أمني، تحقّق من عنوان المصدر والقائمة الرسمية للبوت بدل الاكتفاء بنص User-Agent.
- افحص سجلات الاستضافة أو Cloudflare بحثًا عن طلبات البوتات الحقيقية وحالات
200و403و429و5xx. وجود 200 لا يضمن أن الصفحة سليمة أو مُفهرسة، لكنه بداية جيدة لتشخيص الوصول. - أعد فحص صفحات نموذجية وملف Sitemap وأدوات Google Search Console وBing Webmaster Tools بعد التعديلات.
وفق توثيق Cloudflare, قد تسمح بالبوت من AI Crawl Control لكنه يظل محجوبًا بسبب قاعدة WAF أخرى. وعلى الخطط المجانية قد يتم التعرف على بعض البوتات عبر User-Agent، وهي طريقة يمكن تقليدها؛ لذلك التحقق الإضافي مهم قبل تجاوز إجراءات الحماية.
كيف تتحقق أن زيارة البوت حقيقية وليست مزيفة؟
الـ User-Agent مجرد تعريف يرسله الزائر، وسهل تقليده. تحقق من نطاق IP المنشور رسميًا بصيغة CIDR؛ واستخدم Reverse DNS مع Forward DNS حين تدعم الشركة ذلك (مثل Google وApple). عند الإمكان استفد من Verified Bots في جدار الحماية بدل بناء قواعد واسعة تسمح لأي طلب يحمل اسم بوت مشهور. لا تضف قاعدة «Skip All Security» بناءً على User-Agent فقط.
سادسًا: تحسين GEO الحقيقي بعد السماح للبوتات
السماح بالزحف خطوة تقنية مهمة، لكنها وحدها مش استراتيجية GEO. Google تؤكد أن الظهور في AI Overviews وAI Mode لا يحتاج ملفات خاصة أو حيل جديدة؛ الأساس هو محتوى جيد قابل للفهرسة، وروابط واضحة، وتجربة مستخدم قوية. ومن الخطوات العملية:
- اكتب إجابة واضحة ومباشرة على سؤال القارئ من أول فقرتين، ثم توسع في الأمثلة بدل حشو الكلمات المفتاحية.
- استخدم عناوين H2 وH3 منطقية وجداول مقارنة وأمثلة دقيقة عندما تكون مفيدة، مع تاريخ تحديث ظاهر للمحتوى سريع التغير.
- استشهد بوثائق الشركات الأصلية وفسّر الفرق بين الرأي والمعلومة الرسمية، خاصة في الموضوعات التقنية.
- أضف صورًا أصلية ذات Alt Text مناسب، وروابط داخلية لمقالات قريبة، وبيانات منظمة صحيحة عندما تناسب المحتوى.
- تابع الإحالات من
chatgpt.comوperplexity.aiوclaude.aiفي أدوات التحليل، مع مراعاة أن بعض الزيارات لا تنقل referrer قابلًا للقياس. - راجع تقارير Google Search Console الخاصة بالميزات التوليدية المتاحة في 2026، واختبر أسئلة فعلية تتعلق بموضوع موقعك بدل الاعتماد على فحص بوتات فقط.
ولو عندك مدونة WordPress، ممكن تراجع أيضًا على نولوجي: أفضل قوالب WordPress المجانية، وكيفية اختيار قالب WordPress عربي لمتجرك، ودليل أخبار وتحديثات الذكاء الاصطناعي.
وماذا عن llms.txt؟
يمكنك استخدام llms.txt كملف إرشادي لبعض الأدوات التي تختار قراءته، لكنه ليس شرطًا للفهرسة ولا ضمانًا للظهور. Google قالت صراحة في دليلها لعام 2026 إنها لا تستخدم هذا الملف لتحسين ترتيب صفحات Google Search أو ميزاته التوليدية، فلا تقدمه على إصلاح أخطاء الزحف والمحتوى. المصدر: Google AI Optimization Guide.
أسئلة شائعة عن AI Bots وGEO
هل السماح بـ GPTBot يخلّي موقعي يظهر في ChatGPT؟
لا بالضرورة. GPTBot يرتبط بالتدريب؛ وللظهور في بحث ChatGPT الأهم هو عدم حظر OAI-SearchBot وتوفير محتوى يمكن اكتشافه وفهمه.
هل أحتاج أسمح بكل عناوين IP الخاصة بشركات AI؟
لا. اسم الشركة لا يكفي لتوثيق الزائر. استخدم نطاقات IP الرسمية لكل بوت مطلوب، ولا تفتح نطاقات مزود سحابي بالكامل أو توقف الحماية بشكل شامل.
هل أقدر أمنع التدريب وأسمح بالبحث؟
في بعض الأنظمة نعم، مثل OpenAI وAnthropic التي توفر بوتات منفصلة. لكن افهم تفاصيل كل منصة؛ Google-Extended قد يؤثر على تدريب Gemini وبعض استخدامات الاستناد إلى المحتوى داخل Gemini Apps.
هل robots.txt كفاية للسماح بالزحف؟
لا؛ يلزم أن تعمل الصفحة فعليًا، ولا تكون محجوبة من WAF أو noindex أو تسجيل الدخول، وأن تقدم محتوى نصيًا يمكن الوصول إليه.
هل يمكن ضمان ظهور موقعي في إجابات Gemini أو ChatGPT؟
لا، لا يوجد ضمان للظهور أو الاستشهاد حتى لو طبقت كل الخطوات. الهدف هو إزالة الموانع وتحسين جودة وقابلية اكتشاف المحتوى.
المصادر الرسمية المستخدمة في إعداد هذا الدليل
- OpenAI – التوثيق الرسمي
- Google – bots – التوثيق الرسمي
- Google – AI Search – التوثيق الرسمي
- Anthropic – التوثيق الرسمي
- Perplexity – التوثيق الرسمي
- Cloudflare – التوثيق الرسمي
- Apple – التوثيق الرسمي
- Amazon – التوثيق الرسمي
- Common Crawl – التوثيق الرسمي
- Brave – التوثيق الرسمي
ملاحظة تحريرية: سياسات البوتات ونطاقات IP تتغير باستمرار. راجع التوثيق المباشر للشركات قبل إنشاء قواعد Firewall جديدة، واحفظ نسخة من إعداداتك الحالية قبل تعديل robots.txt. تم إعداد هذا الدليل بالاستناد إلى المصادر المذكورة ومراجعته في 3 نوفمبر 2026.


